

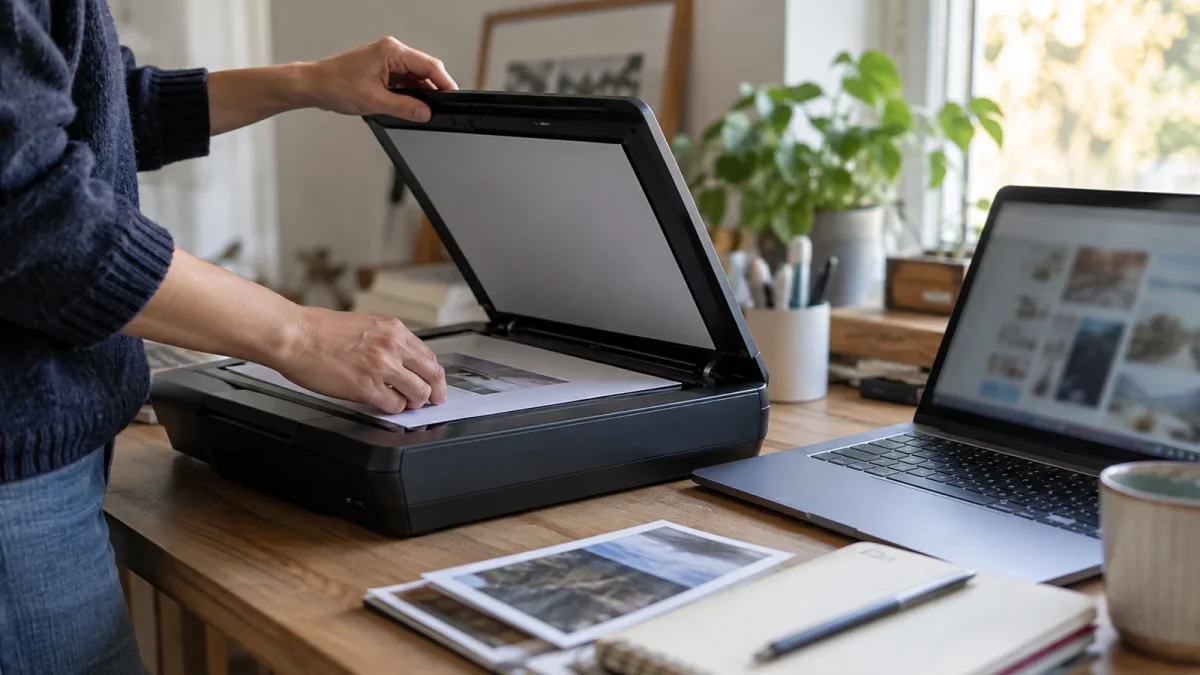
Le PDF est lisible, mais Ctrl + F ne trouve aucun mot pourtant visible sur la page. Vous essayez de sélectionner une phrase et seule une zone d’image semble réagir. Le document peut contenir une numérisation, sans texte exploitable par la recherche. Il ne suffit pas qu’un mot soit dessiné à l’écran pour que le logiciel sache qu’il s’agit de ce mot.
Une page peut être une simple image
Un PDF numérisé peut conserver la photographie ou le scan d’une feuille. Les lettres sont alors des pixels, comme dans une photo, et non des caractères que le lecteur peut rechercher. Le fichier s’ouvre correctement parce que l’image est présente ; la recherche échoue parce qu’aucune couche de texte correspondante n’est disponible.
Un PDF exporté depuis un traitement de texte peut, lui, contenir du texte directement exploitable. Certains documents mélangent les deux : quelques pages sont recherchables, d’autres uniquement constituées d’images. Testez plusieurs pages avant de conclure que tout le fichier possède la même structure.
L’OCR ajoute une interprétation des caractères
La reconnaissance optique de caractères, ou OCR, analyse l’image pour identifier des lettres et des chiffres. Un outil peut ensuite rendre le texte sélectionnable et recherchable, parfois en ajoutant une couche associée à la page. Les fonctions disponibles dépendent du logiciel et de sa formule.
Cette reconnaissance reste une interprétation.
Une feuille inclinée, une impression peu nette, une écriture manuscrite ou des caractères proches peuvent produire des erreurs. Un zéro devient parfois une lettre O, et un nom peut être mal reconstitué. Le résultat doit être contrôlé lorsqu’il sert à recopier une référence, un montant ou une donnée importante.
Un test rapide permet d’identifier le besoin
Essayez de sélectionner quelques mots, puis recherchez un terme simple présent plusieurs fois. Si la sélection récupère un texte incohérent, une couche existe peut-être mais a été mal reconnue. Si rien n’est sélectionnable, le document peut nécessiter une étape d’OCR ou présenter une autre restriction.
Vérifiez également les réglages et protections du fichier. Une impossibilité de copier peut venir d’un autre mécanisme que l’absence de texte. Le symptôme doit donc être observé précisément : recherche, sélection et copie ne sont pas toujours limités de la même manière.
Préparer le document avant la reconnaissance
Pour une nouvelle numérisation, privilégiez une page bien éclairée, cadrée et droite. Évitez les ombres au pli d’un livre et les doigts qui masquent une ligne. Une meilleure image d’entrée réduit le besoin de corrections après traitement.
Choisissez la langue adaptée lorsque l’outil le permet et traitez les pages utiles. Gardez l’original avant de lancer une modification. Pour des documents personnels, examinez aussi où le traitement est effectué et quelles données sont transmises à un service externe.
Le passage d’un format à l’autre ne retire pas automatiquement les informations sensibles. Les contrôles prévus pour un document Word apparemment finalisé rappellent qu’il faut regarder le fichier transmis, pas seulement son extension ou son apparence.
Contrôler avant de réutiliser le texte
Après OCR, recherchez quelques mots connus et comparez les chiffres avec la page visible. Vérifiez particulièrement les tableaux : l’ordre de lecture peut changer lorsque les colonnes sont mal interprétées. Un copier-coller peut réunir deux cellules ou déplacer une information loin de son libellé.
Pour une archive, conservez une copie recherchable et l’image originale lorsque cela répond à votre besoin. Pour une extraction, relisez les éléments qui seront utilisés ailleurs. La recherche devient pratique grâce à l’OCR, mais elle ne transforme pas chaque caractère reconnu en information certaine.
Un PDF qui s’ouvre sans erreur peut donc rester difficile à exploiter. Identifier sa structure vous permet de choisir la bonne action : utiliser le texte déjà présent, lancer une reconnaissance ou refaire une numérisation plus lisible, plutôt que multiplier les recherches sur une page que le logiciel voit encore comme une image.

Je suis Romain Delcourt, rédacteur tech passionné par le numérique et l’intelligence artificielle. J’écris pour décoder les tendances, les outils et les changements qui façonnent nos usages au quotidien.

Un commentaire sur “Votre PDF s’ouvre parfaitement, mais aucun mot n’est trouvable : voici pourquoi”