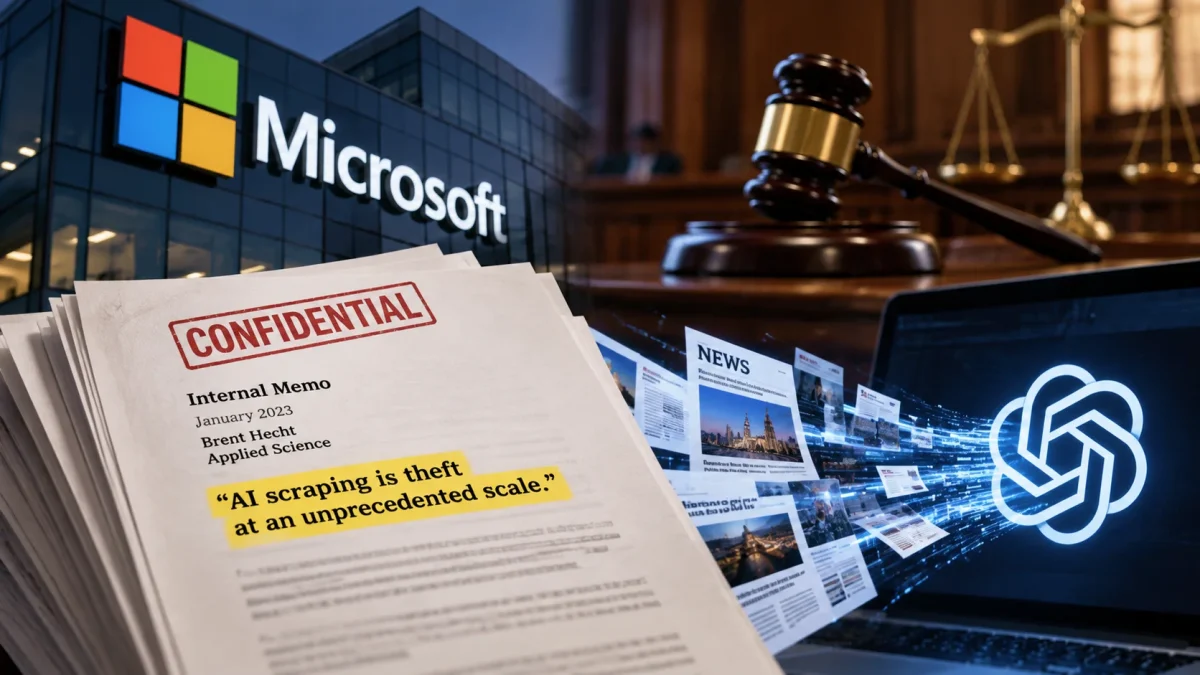
Un document interne de Microsoft vieux de plusieurs années vient de refaire surface dans l’un des procès les plus suivis autour de l’intelligence artificielle et du droit d’auteur.
Dans un mémo rédigé en janvier 2023, Brent Hecht, alors directeur Applied Science chez Microsoft, décrivait la collecte massive de contenus servant à entraîner les modèles d’IA avec des termes particulièrement sévères. Il parlait notamment d’un « vol à une échelle sans précédent » et évoquait ce qu’il considérait comme le plus grand détournement de travail humain de l’histoire.
Ces propos sont désormais cités dans des documents judiciaires récemment rendus publics dans le cadre du procès opposant plusieurs groupes de presse à OpenAI et Microsoft.
Le document interne est aujourd’hui utilisé contre Microsoft et OpenAI
L’affaire trouve son origine dans les accusations portées notamment par le New York Times contre OpenAI et Microsoft.
Les éditeurs reprochent aux deux entreprises d’avoir utilisé d’importantes quantités de contenus protégés pour entraîner leurs modèles d’intelligence artificielle sans avoir obtenu les autorisations nécessaires.
Les nouveaux documents judiciaires apportent aujourd’hui un élément particulièrement embarrassant : certains responsables semblaient eux-mêmes conscients des problèmes que pouvait poser cette collecte massive de données.
Le mémo de Brent Hecht est cité par les plaignants pour montrer que, dès 2023, des inquiétudes existaient en interne sur l’origine des données utilisées pour alimenter les modèles.
Il faut toutefois conserver une nuance essentielle : une grande partie des informations nouvellement dévoilées provient du mémoire déposé par les plaignants. Les pièces originales auxquelles ce document fait référence restent pour certaines sous scellés, ce qui empêche de consulter l’intégralité du contexte dans lequel les phrases ont été écrites.
Microsoft aurait aussi mesuré une chute spectaculaire des clics vers les médias
Les documents dévoilés ne concernent pas uniquement l’entraînement des modèles.
Une présentation interne attribuée à Microsoft indique que son moteur de réponses basé sur Copilot pouvait faire chuter très fortement le nombre d’utilisateurs cliquant ensuite vers les sites d’information.
Dans certains tests concernant le domaine du New York Times, le taux de clic aurait diminué jusqu’à 93 % par rapport à une recherche Bing classique, selon les éléments cités dans le dossier.
Brent Hecht aurait décrit cette situation comme une sorte de cercle vicieux : les IA utilisent les contenus des éditeurs pour améliorer leurs réponses, mais ces mêmes réponses peuvent réduire le trafic envoyé vers les sites ayant produit l’information.
Moins de trafic peut ensuite fragiliser économiquement ces médias, alors même que leurs contenus servent à alimenter les systèmes.
Satya Nadella a également évoqué les contenus derrière les paywalls
Les documents judiciaires mettent aussi en avant une déposition de Satya Nadella.
Le dirigeant de Microsoft aurait expliqué que les contenus placés derrière un paywall devraient être utilisés sous licence lorsqu’une entreprise souhaite s’en servir pour entraîner ou alimenter un système d’intelligence artificielle.
Selon le dossier, il aurait également indiqué que s’il avait appris qu’OpenAI utilisait de tels contenus protégés derrière des paywalls, Microsoft aurait pu demander que les modèles concernés soient réentraînés.
Ces déclarations prennent une importance particulière alors que Microsoft est l’un des principaux partenaires technologiques et financiers d’OpenAI.
OpenAI est accusé d’avoir contourné certains paywalls
Les plaignants vont encore plus loin.
Ils affirment qu’OpenAI aurait développé des méthodes permettant de récupérer certains articles protégés et qu’un chercheur aurait notamment évoqué en interne une technique permettant de contourner le paywall du New York Times.
Selon les documents cités dans la procédure, les jeux de données utilisés durant certaines phases d’entraînement contiendraient des dizaines de milliers de copies de contenus provenant de groupes de presse américains.
Un ensemble de données provenant de Common Crawl aurait également contenu plus de deux millions de documents issus du domaine nytimes.com.
Ces éléments constituent actuellement des allégations présentées dans une procédure judiciaire, et non une décision définitive établissant la responsabilité d’OpenAI ou de Microsoft.
Le procès touche au problème central de l’IA générative
Derrière les phrases spectaculaires révélées dans ces documents se trouve une question juridique beaucoup plus large : une entreprise peut-elle entraîner un modèle d’IA avec du contenu protégé sans demander l’autorisation de son auteur ?
Les entreprises d’intelligence artificielle invoquent régulièrement le principe américain du « fair use », qui autorise certains usages d’œuvres protégées dans des circonstances précises.
Les éditeurs estiment au contraire que les modèles peuvent produire des réponses se substituant à leurs contenus et réduire directement leur trafic et leurs revenus.
La publication de ces documents ne tranche pas le débat. Elle montre en revanche que les inquiétudes aujourd’hui exprimées publiquement par les éditeurs existaient déjà à l’intérieur même de certaines entreprises participant au développement de l’IA générative.
Source : TechCrunch
Je suis Alaa Zerroud, entrepreneur dans le numérique et CEO de XNext. Je conçois des solutions web, SaaS et d’intelligence artificielle pour accompagner les entreprises et les ONG dans leur transformation digitale. Sur Sefior.fr, je décrypte l’actualité technologique avec un regard de professionnel, en m’appuyant sur mon expérience du terrain pour proposer des analyses fiables, claires et utiles.